

今年4月,Google才在雲端年會上將第八代TPU分成訓練與推論兩款,不到七個月,又推出主打機密推論的TPU 8tx,以及鎖定超長上下文的TPU 8i Max。一年推出四款TPU系統,Google為何加快腳步?硬體分工愈來愈細,企業和開發者又該怎麼選擇?
今年4月的Google Cloud Next上,Google首度在同一代TPU中推出兩款產品,分別是訓練用的TPU 8t,以及推論用的TPU 8i。
過去的TPU兼顧訓練與推論,如今Google開始針對不同工作負載設計專用產品;AWS也有Inferentia與Trainium的分化,反映AI晶片分工愈來愈細的趨勢。
今年9月的半導體盛會SEMICON Taiwan,Google首席技術專家暨AI與基礎設施資深副總裁瓦達特(Amin Vahdat)首度來台,並擔任開幕主講。
會後的記者會上,《遠見》記者曾向他提問,隨著AI代理時代(agentic era)到來,TPU是否會進一步細分?當時他的回答相當乾脆:「這是不可避免的。」
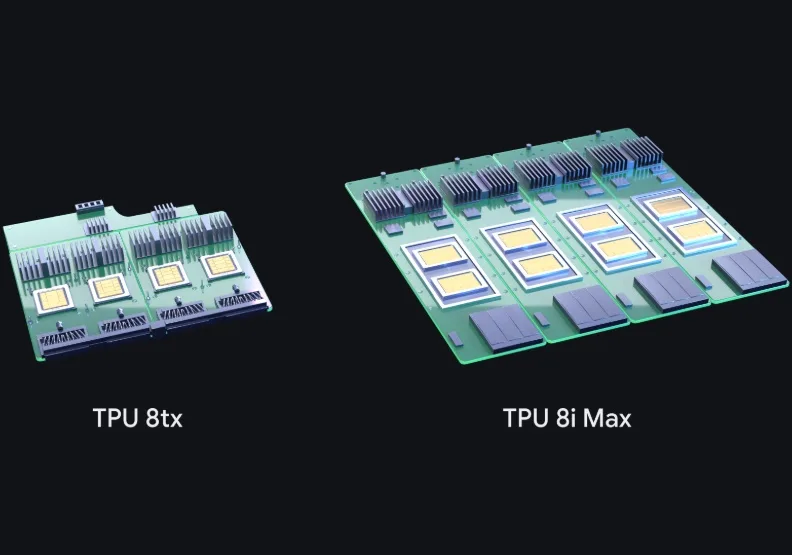
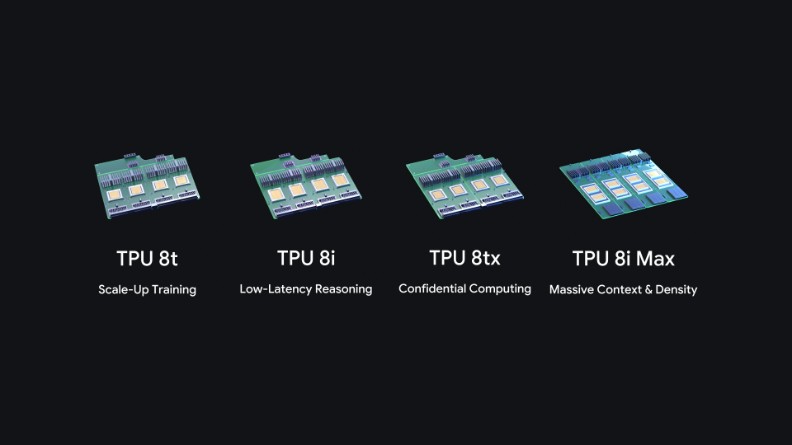
不到兩個月,答案便揭曉。Google今日(11/9)宣布推出專為機密推論設計的TPU 8tx,以及主打超長上下文的TPU 8i Max,加上今年4月發表的兩款產品,Google一年內已推出四款第八代TPU系統。
AI Agent改變算力需求,Google加速TPU分工
「我們看到市場對TPU有著極大的需求,」Google Cloud AI與運算基礎架構副總裁暨總經理羅邁爾(Mark Lohmeyer)在正式發表消息之前的媒體簡報中,解釋Google加速推出TPU的原因。
他表示,隨著新的應用情境陸續浮現,Google也加快產品推出速度,從過去每兩年推出一款TPU,到後來一年一款,今年更一口氣推出四款。
推動這波需求成長的關鍵,就是AI Agent的興起。
延伸閱讀:AI Agent來了,但它是什麼?AI代理定義、應用、挑戰全解讀
羅邁爾形容,聊天機器人時代,使用者問一句、AI答一句;進入AI Agent時代,一個請求可能在背後觸發數百甚至數千次操作。Agent還得讀取大量文件與電子郵件,並在長時間執行任務的過程中維持上下文。
這也讓AI運算面臨新的挑戰。除了TPU或GPU的數量,資料傳輸速度、記憶體使用效率等因素,也會影響Agent執行任務的速度。
另一方面,客戶需求也愈來愈多元。瓦達特在官方部落格的文章中透露,Google的TPU客戶已接近100家,涵蓋前沿AI實驗室、交易公司與大學等。有些客戶需要處理大量上下文,有些高度受監管的企業則要求更嚴密的資料保護機制,促使Google針對不同工作負載(workload)打造專用系統。
不過,什麼情況下,值得為特定需求再推出一款TPU?瓦達特在SEMICON Taiwan期間曾提出判斷標準,唯有需求規模夠大,專用硬體帶來的效能與能源效率優勢,才足以支撐開發成本。
今年4月,Google先將訓練與推論分工,如今進一步針對機密運算與長上下文推出新產品,也顯示Google看好這兩類需求的成長潛力。
新產品能夠快速問世,還有另一個原因。這次兩款TPU系統並未採用全新晶片。TPU 8tx沿用8t的晶片,8i Max則將兩顆8i晶片整合在同一封裝中。瓦達特解釋,從頭設計新晶片往往需要數年,但透過調整封裝、記憶體、網路與安全功能,便有機會在數個月內推出新產品。
AI Agent運算面臨挑戰,新TPU希望解決資料外洩風險與記憶體問題
TPU 8tx主要回應企業使用AI時,對敏感資料外洩的顧慮。一般而言,資料在儲存與傳輸時可以加密保護,但進入運算階段,往往必須先解密,增加資料暴露的風險。
為了解決這個問題,Google讓TPU 8tx搭配超微(AMD)客製化CPU主機,透過硬體層級的機制,在運算過程中也能保護敏感資料。羅邁爾指出,從CPU傳送至TPU的資料,包括模型權重、提示詞與企業資料,都能受到加密保護,「甚至能防止操作這些系統的人員存取。」
此外,8tx也採用低延遲的Boardfly網路,相較8t,延遲最多可降低約一半。Google鎖定的客戶包括金融等高度監管產業,以及擔心模型權重外洩的AI模型開發商。
另一款TPU 8i Max,則著重解決AI Agent的記憶體瓶頸。
當數十個Agent同時分析大量程式碼或文件,記憶體容量與頻寬就可能成為限制。羅邁爾指出,企業這時只能縮減Agent能讀取的資料量、限制同時執行的任務數量,或接受較慢的回應速度,「顯然沒有人想做這種妥協。」
Google因此將兩顆8i晶片整合在同一封裝中,相較8i,8i Max的運算能力、SRAM容量與HBM頻寬均翻倍,HBM容量則從288GB增加約33%,達384GB。
羅邁爾以高速公路比喻,增加記憶體頻寬,就像拓寬道路、增加車道。每輛車不一定跑得更快,但同一時間能容納更多車輛通行,讓大量Agent同時讀寫資料時,減少因頻寬不足造成的壅塞。
晶片分工只是第一步,Google還得突破生態系門檻
不過,TPU分工愈來愈細,企業會不會反而更難使用?畢竟,不同晶片各有用途,企業若得自行判斷該用哪一款、如何分配算力,管理成本恐怕也會增加。
對此,羅邁爾表示,Google透過軟體統一管理不同晶片,讓企業不必逐一操作。例如,企業可以事先設定調度策略,推論工作先在輝達GPU上執行,GPU資源不足時,後續工作再改由TPU 8i執行。「從工作負載的角度來看,你其實是在一個統一的資源池裡運作。」
Google也試圖降低開發者使用TPU的門檻。過去,工程師若想將既有AI程式轉移到TPU,往往得花時間修改程式碼。Google上個月開源TorchTPU,讓使用主流AI開發工具PyTorch的團隊,更容易將程式與模型轉移到TPU。羅邁爾表示,開發者可能只需要修改一、兩行設定。
Google擴大TPU布局,也牽動台灣供應鏈。瓦達特在SEMICON Taiwan期間曾提到,Google許多晶片設計與製造工作,都與台灣合作伙伴共同完成,新晶片上線後也由台灣團隊負責測試。這次兩款新系統的差異主要來自封裝、記憶體與網路設計,也凸顯台灣供應鏈在Google自研晶片布局中的重要性。
不過,輝達GPU仍擁有成熟的軟體生態系與龐大的開發者基礎,AWS等雲端業者也持續發展自研晶片。TPU能否打開更大市場,除了讓開發者更容易轉換平台,還得證明其專用硬體,真的能為企業帶來效能與成本優勢。